1. Analytics एक नज़र में
सेमीकंडक्टर बड़े पैमाने के उत्पादन के STDF V4 datalog में हज़ारों पैरामीट्रिक टेस्ट (PTR, MPR) और लाखों parts (PRR) दर्ज होते हैं। केवल यह जान लेना कि parts spec limits (LL/HL) के भीतर pass हुए, यह नहीं बताता कि निर्माण प्रक्रिया स्थिर है या नहीं, माप पर भरोसा किया जा सकता है या नहीं, या अच्छी इकाइयों के बीच संभावित रूप से खतरनाक outlier parts तो नहीं छिपे हैं।
DLOG इन महत्वपूर्ण प्रश्नों के उत्तर देने के लिए विशेष एनालिटिक्स स्क्रीन देता है। इंटरफ़ेस के शीर्ष पर दृश्य चयनकर्ता से पहुँचे जा सकने वाले, प्रक्रिया-क्षमता, outlier स्क्रीनिंग और माप-विश्वसनीयता को समर्पित दृश्यों को यह गाइड समझाती है।
 बड़ा करने के लिए क्लिक करें
| विश्लेषण | DLOG स्क्रीन | प्रमुख मेट्रिक्स | कब उपयोग करें |
|---|---|---|---|
| PAT+ Outlier स्क्रीनिंग | Wafer (PAT Data / PAT+), Chart (DPAT bands) | DPAT bands, SPAT पड़ोसी residual, PAT+ Flips | ऐसे “अच्छे die के बीच संदिग्ध parts” छाँटें जो spec limits पास करते हैं लेकिन वितरण या पड़ोस से भिन्न हैं। |
| बहुचर Outliers | MVA Explorer, Wafer (MVA-PAT) | Mahalanobis MD², PCA SPE, Isolation Forest | ऐसे parts पहचानें जिनके अलग-अलग टेस्ट spec के भीतर हैं, लेकिन मानों का संयोजन असामान्य है। |
| Gauge R&R | Gauge R&R | EV, AV, PV, %GRR, %P/T, ndc | उसी wafer के बार-बार किए गए टेस्ट रन से माप प्रणाली की repeatability और reproducibility का मूल्यांकन करें। |
| Site Delta | SITE, Group Analysis (Group by: Site) | प्रति-site yield, BIN, माध्य, η², ANOVA | पहचानें कि क्या कोई एक probe card pin, socket संपर्क या channel व्यवस्थित विचलन का कारण है। |
| प्रक्रिया-क्षमता | Chart, Dashboard, Group Analysis | Cpk, Cp, Est ppm, Normality (Anderson-Darling) | spec margin को मात्रात्मक करें, ppm दोष दर का अनुमान लगाएँ, और सत्यापित करें कि सामान्य वितरण की धारणाएँ टिकती हैं या नहीं। |
| Correlation और TTO | Correlation, TTO Engine | Pearson r, Spearman ρ, अनावश्यक टेस्ट उम्मीदवार | एक ही भौतिक व्यवहार मापने वाले duplicate टेस्ट पहचानें ताकि टेस्ट समय घटाने की संभावना खोजी जा सके। |
माध्य और मानक विचलन Welford ऑनलाइन एल्गोरिद्म से एक ही पास में निकाले जाते हैं। यह संख्यात्मक रूप से स्थिर सूत्रीकरण वर्गों के योग को भोलेपन से जोड़ने पर होने वाली विनाशकारी cancellation से बचाता है:
2. PAT+ Outlier स्क्रीनिंग (DPAT · SPAT)
PAT (Part Average Testing) ऑटोमोटिव सेमीकंडक्टर गुणवत्ता दिशानिर्देश AEC-Q001 में परिभाषित है। इसका उद्देश्य उन parts को छाँटना है जो मानक specification limits पास करते हैं लेकिन जनसंख्या के सामान्य वितरण से बाहर पड़ते हैं, जिससे फ़ील्ड में शुरुआती जीवन की विफलताएँ (infant mortality) घटती हैं।
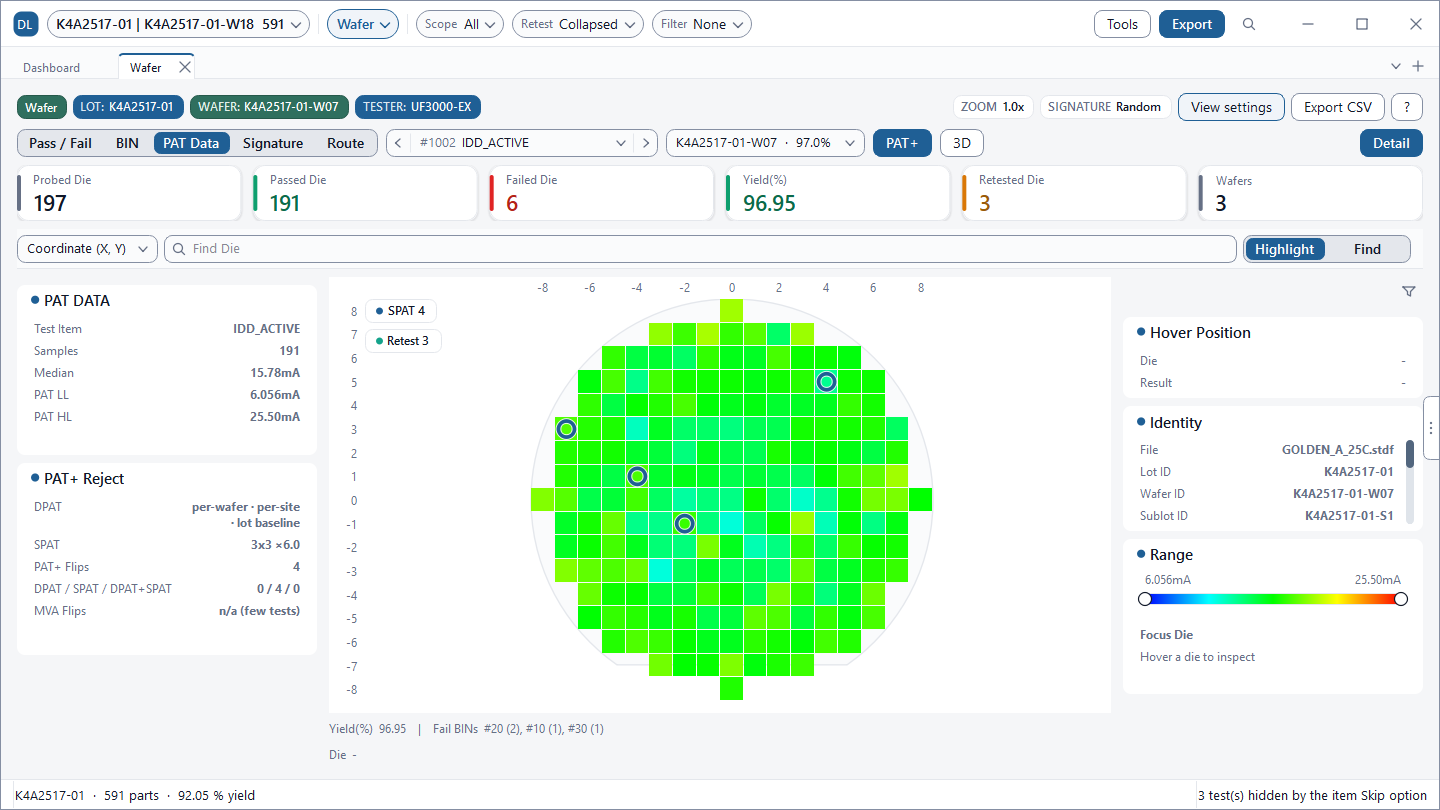
Wafer स्क्रीन के PAT Data मोड में, DLOG चुने हुए टेस्ट के लिए PAT limits (PAT LL / HL) की गणना करके दिखाता है। जब आप view settings में PAT+ चालू करते हैं, तो जो die टेस्ट spec पास कर चुके हैं लेकिन DPAT या SPAT नियमों द्वारा संदिग्ध चिह्नित हैं, वे wafer map पर ओवरले के रूप में हाइलाइट होते हैं। मूल टेस्ट PASS/FAIL निर्णय सुरक्षित रहता है।
 बड़ा करने के लिए क्लिक करें
 बड़ा करने के लिए क्लिक करें
DPAT: डेटा से पुनर्गणित मज़बूत डायनामिक Limits
चरम outlier को नमूना माध्य और मानक विचलन को पक्षपाती बनाने से रोकने के लिए, DLOG माध्य के बजाय median और interquartile range (IQR) से अनुमानित मज़बूत sigma का उपयोग करता है:
इस सीमा के बाहर पड़ने वाले die outlier उम्मीदवार के रूप में चिह्नित किए जाते हैं। डिफ़ॉल्ट sigma गुणक k 6 है। आप ऊपरी और निचले गुणक को View settings > Wafer View Options > Lower Sigma (L) / Upper Sigma (H) से स्वतंत्र रूप से कॉन्फ़िगर कर सकते हैं। k के छोटे मान अधिक उम्मीदवार पकड़ते हैं।
DPAT (Dynamic PAT) स्थिर limits के बजाय इन limits का प्रति wafer, प्रति site या प्रति lot baseline के अनुसार गतिशील रूप से पुनर्मूल्यांकन करता है। Site-विशिष्ट DPAT टेस्टर हार्डवेयर offset हटाता है, जबकि lot-baseline DPAT wafer-से-wafer तापीय और प्रक्रिया drift को ट्रैक करता है। Chart स्क्रीन के Trend दृश्य में आप DPAT (trend) विकल्प से वही डायनामिक limits ओवरले कर सकते हैं।
SPAT: स्थानिक पड़ोसी Residual
स्थानीय विसंगतियाँ — जैसे किनारे के क्लस्टर, खरोंच या बिंदु-जैसे दोष क्लस्टर — व्यापक wafer वितरण में घुल-मिल सकती हैं और स्थानिक संदर्भ के बिना अनदेखी रह सकती हैं। SPAT (Spatial PAT) लक्ष्य die $(i, j)$ और पड़ोसी PASS die के median के बीच के residual का मूल्यांकन पड़ोस की मज़बूत sigma के विरुद्ध करता है:
डिफ़ॉल्ट स्थानिक kernel $3 \times 3$ है जिसका गुणक 6.0 है। wafer की सीमाओं या घने दोष क्षेत्रों के पास जहाँ वैध PASS पड़ोसी कम होते हैं, DLOG न्यूनतम पड़ोसी सीमा पूरी होने तक kernel को अपने-आप 2 संकेंद्री रिंग तक बाहर की ओर बढ़ा देता है।
PAT Sigma चुनना: Yield Loss बनाम Quality Risk
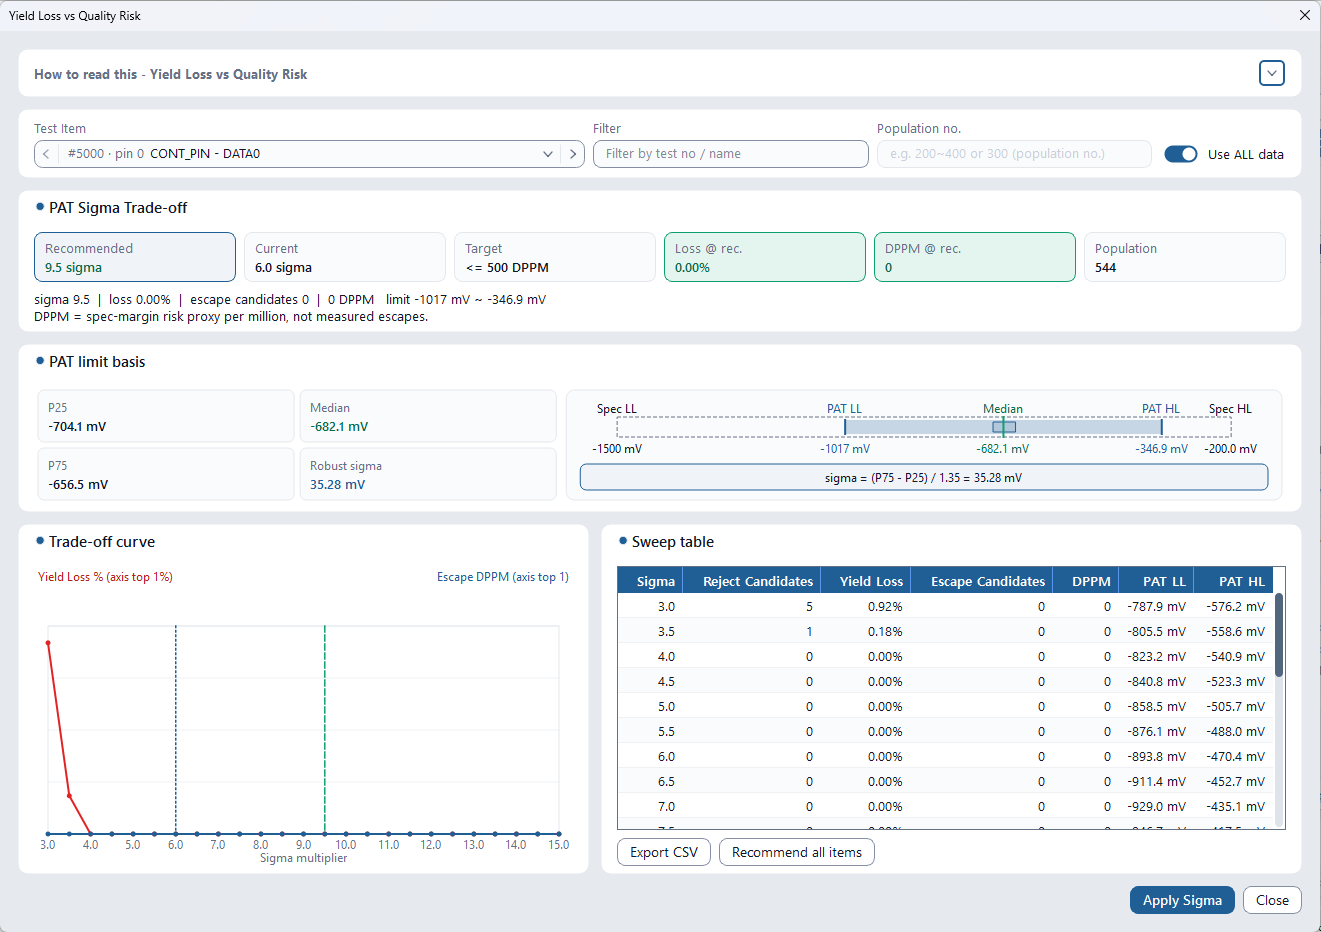
k को कसने से अधिक संदिग्ध die पकड़ में आते हैं, लेकिन अच्छे सिलिकॉन की बलि देकर overkill (yield loss) बढ़ता है। Tools > Studies > Yield Loss vs Quality Risk टेस्टों के पार sigma मानों को स्वीप करके Reject Candidates, Yield Loss और DPPM वक्र प्लॉट करता है, और आपके लक्ष्य DPPM को पूरा करने के लिए इष्टतम sigma संतुलन सुझाता है। तुरंत लागू करने के लिए Apply Sigma पर क्लिक करें।
3. MVA Explorer (बहुचर Outliers)
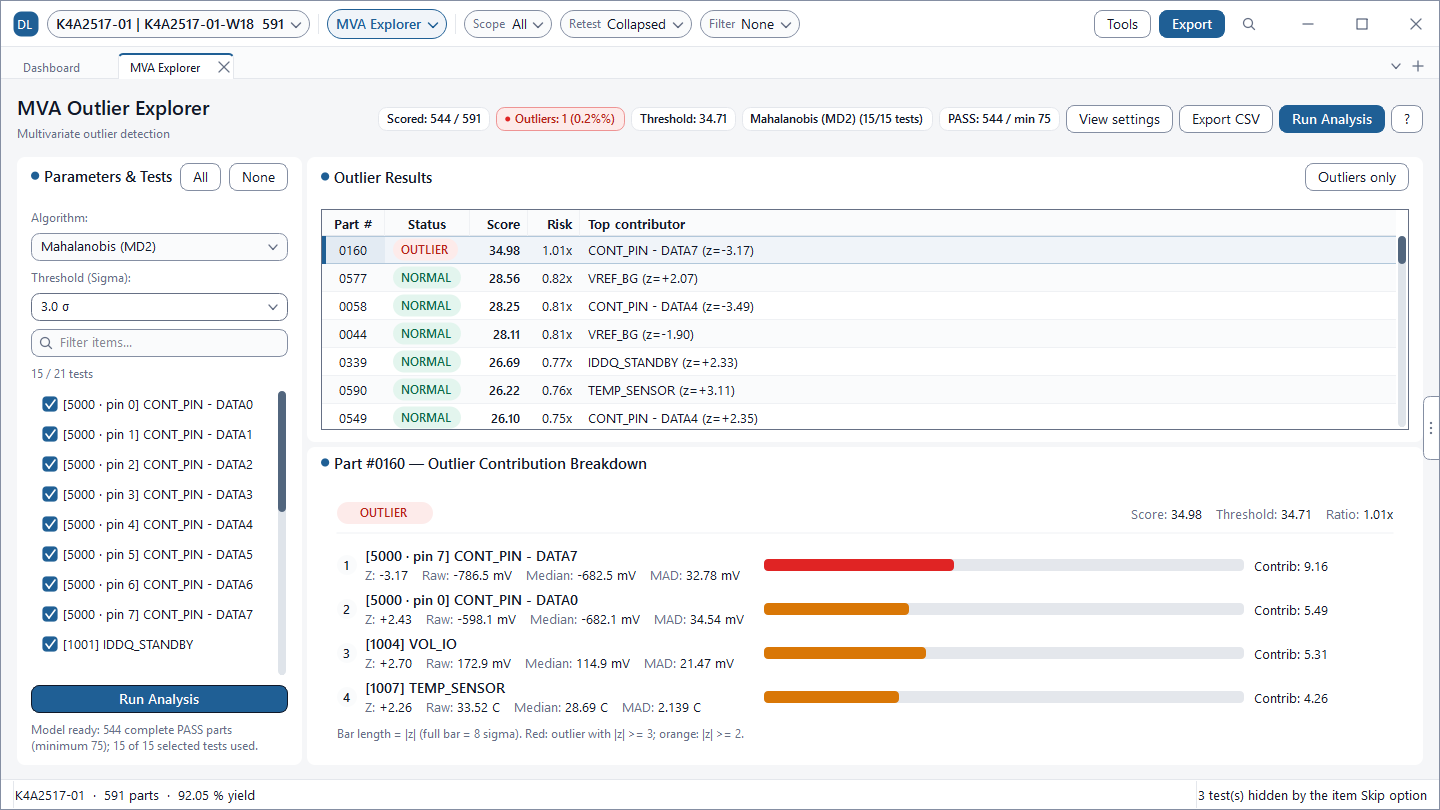
संबंधित पैरामीट्रिक टेस्ट अक्सर साथ-साथ बदलते हैं। Test A और Test B का अलग-अलग मूल्यांकन करने पर कोई die बिल्कुल सामान्य लग सकता है, लेकिन यदि Test A असामान्य रूप से ऊँचा और Test B असामान्य रूप से नीचा हो, तो यह जोड़ी सामान्य भौतिक सहसंबंध तोड़ती है। भले ही यह अलग-अलग अदिश limits पास करता हो, यह स्पष्ट बहुचर outlier है। MVA Explorer ऐसी बहु-आयामी विसंगतियाँ पकड़ता है।
 बड़ा करने के लिए क्लिक करें
तीन Outlier पहचान एल्गोरिद्म
| एल्गोरिद्म | यह Outliers कैसे पहचानता है | सर्वोत्तम उपयोग कब |
|---|---|---|
| Mahalanobis (MD²) | पूर्ण covariance को ध्यान में रखने वाली सांख्यिकीय दूरी। chi-square वितरण सीमा से अधिक वाले parts को चिह्नित करता है। | अनुशंसित सामान्य-उद्देश्य डिफ़ॉल्ट |
| PCA reconstruction (SPE) | मुख्य घटकों पर प्रक्षेपित करने पर उच्च reconstruction त्रुटि (Q-statistic) वाले parts को चिह्नित करता है। सामान्य सहसंबंध पैटर्न के टूटने को पकड़ता है। | बड़े टेस्ट सूट के लिए अनुशंसित |
| Isolation Forest | पैरामीट्रिक वितरण की धारणा रहित tree-आधारित विभाजन एल्गोरिद्म। आसानी से अलग किए जा सकने वाले parts पहचानता है और PASS parts में से शीर्ष ~1% को outlier के रूप में रैंक करता है। | गैर-रैखिक, जटिल बहु-मोडल विसंगतियाँ पकड़ता है |
Mahalanobis Distance (MD²)
Euclidean दूरी पैरामीटरों के बीच स्केल अंतर और सहसंबंध को ध्यान में नहीं रखती। Mahalanobis दूरी covariance matrix ($\mathbf{\Sigma}$) के प्रतिलोम से विचलनों को भारित करके इसका समाधान करती है। DLOG एक मज़बूत centroid और shrinkage covariance matrix की गणना करता है, और हर टेस्ट का योगदान $z_i \cdot (\mathbf{\Sigma}^{-1}\mathbf{z})_i$ के रूप में विभाजित करता है ताकि योग $MD^2$ के बराबर हो:
Threshold (Sigma) सेटिंग (3.0 / 4.0 / 5.0 / 6.0σ, डिफ़ॉल्ट 6.0σ) को दो-तरफ़ा सामान्य प्रायिकता $\alpha$ में बदला जाता है, जो $r$ स्वतंत्रता कोटियों (चुने हुए टेस्टों की संख्या) के लिए क्रांतिक chi-square सीमा तय करती है। उच्च sigma सेटिंग कम लेकिन अधिक गंभीर outliers देती है। PCA के लिए, SPE (Squared Prediction Error, Q-statistic) मुख्य घटकों द्वारा अव्याख्यायित अवशिष्ट variance के आधार पर parts को स्कोर करता है।
परिणाम तालिका पढ़ना
| कॉलम | अर्थ |
|---|---|
| Status | OUTLIER · NORMAL · NOT SCORED (चुने हुए टेस्टों में टेस्ट मान अनुपस्थित) · EXCLUDED (non-PASS parts) |
| Score | चुने हुए एल्गोरिद्म का outlier स्कोर (MD², SPE या Isolation Forest स्कोर) |
| Risk | Score ÷ Threshold। 1.0x से अधिक होने पर part को OUTLIER के रूप में वर्गीकृत किया जाता है |
| Top contributor | स्कोर को सबसे अधिक बढ़ाने वाला पैरामीट्रिक टेस्ट, उसके मज़बूत z-score (median और MAD पर आधारित) के साथ |
max(50, 5 × टेस्टों की संख्या) होना चाहिए (जैसे चित्र 3 में, 15 टेस्टों के लिए कम से कम 75 parts)। भौतिक रूप से सहसंबद्ध पैरामीट्रिक टेस्ट चुनें; असंबद्ध टेस्ट शामिल करने से विसंगति स्कोर कमज़ोर होते हैं। Wafer स्क्रीन के MVA-PAT मोड में, आप die निर्देशांक के अनुसार स्थानिक स्कोर देख सकते हैं और PASS से MVA Outliers में बदले parts (MVA Flips) को CSV में export कर सकते हैं।
4. Gauge R&R माप-प्रणाली विश्लेषण
देखा गया माप variance वास्तविक उत्पाद विविधता और टेस्ट प्रणाली (टेस्टर उपकरण, probe card, socket संपर्क, इंटरफ़ेस हार्डवेयर) द्वारा जोड़े गए उतार-चढ़ाव से मिलकर बनता है:
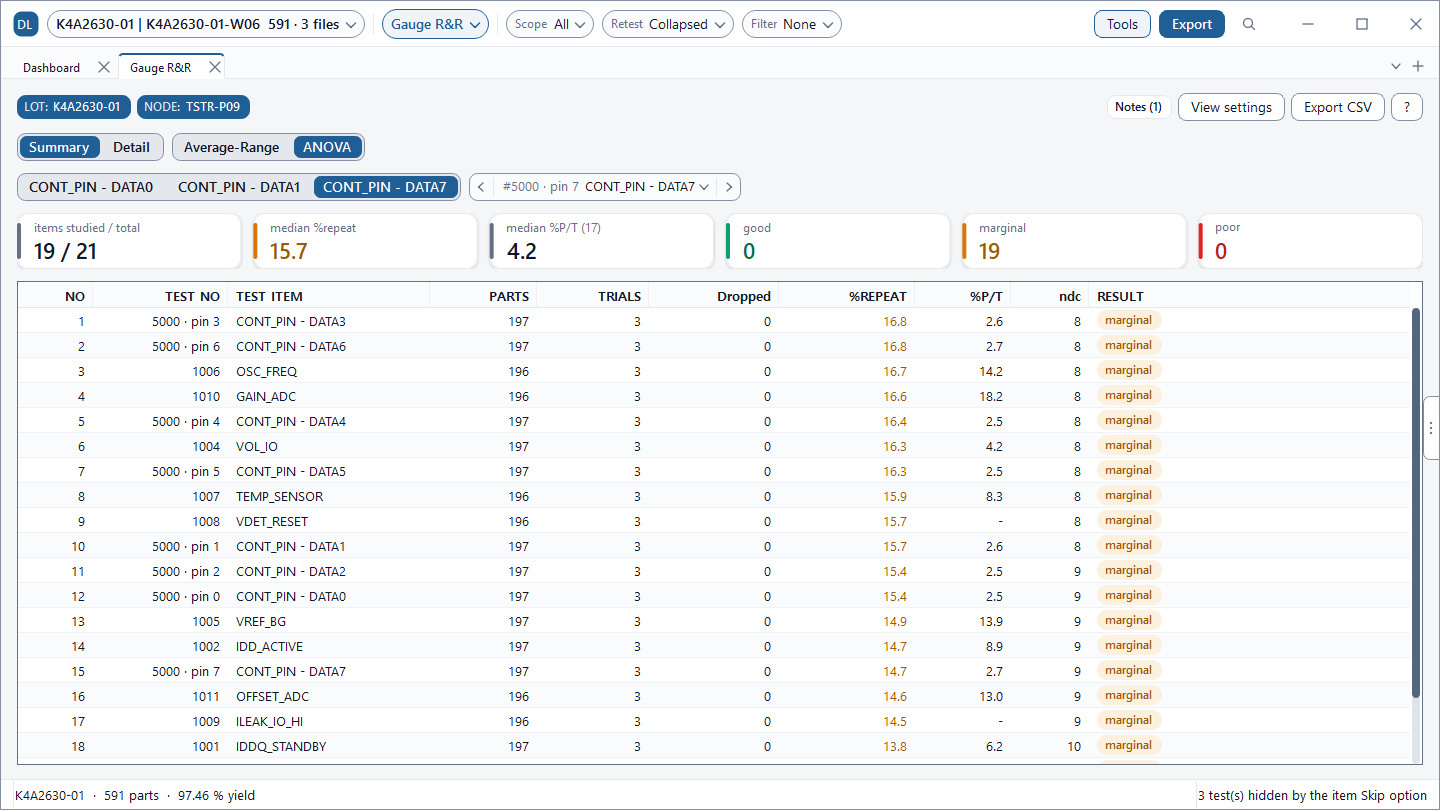
अत्यधिक माप noise के कारण अच्छे उत्पाद के गलत तरीके से अस्वीकृत होने या दोषपूर्ण इकाइयाँ भेजे जाने का जोखिम रहता है। Gauge R&R स्क्रीन उसी wafer के बार-बार किए गए टेस्ट रन से इस कुल variance को विघटित करती है। die को (X, Y) निर्देशांक पर मिलाकर, DLOG दोहराए गए रन को वैध ट्रायल मानता है, भले ही फ़ाइलों में Lot या Wafer ID भिन्न हों।
 बड़ा करने के लिए क्लिक करें
Variance घटक और विधियाँ
| घटक | विवरण |
|---|---|
| EV (Repeatability) Equipment Variation | एक ही शर्तों में एक ही part को बार-बार मापने पर होने वाला उतार-चढ़ाव (टेस्टर का आधार noise)। |
| AV (Reproducibility) Appraiser Variation | अलग-अलग ऑपरेटर, फ़ाइलों या टेस्ट site के बीच विविधता (socket संपर्क में अंतर, तापीय बदलाव)। |
| GRR | $\sqrt{EV^2 + AV^2}$ — माप प्रणाली द्वारा जोड़ी गई कुल विविधता। |
| PV | wafer के पार वास्तविक part-से-part निर्माण विविधता। |
DLOG दो गणना विधियाँ समर्थित करता है: ANOVA (डिफ़ॉल्ट, Mean Squares से variance घटकों का अनुमान लगाता है) और Average-Range (range और $d_2$ गुणांकों का उपयोग करने वाली क्लासिक AIAG वर्कशीट विधि)। ANOVA बड़े नमूना आकारों के लिए बेहतर स्थिरता देता है। दो विश्लेषण मोड उपलब्ध हैं: Repeatability Only (एकल site, AV छोड़ा जाता है) और Cross-Site (जब सभी site हर die को मापते हैं तब टेस्ट site को appraiser के रूप में मूल्यांकित करता है)।
%GRR मानदंड और ndc
| %GRR | निर्णय | व्याख्या |
|---|---|---|
| < 10% | good | माप प्रणाली सक्षम है। यदि ndc ≥ 5 हो, तो resolution भी पर्याप्त है। |
| 10% से 30% | marginal | अनुप्रयोग के महत्व, घटक लागत या मरम्मत व्यय के आधार पर स्वीकार्य हो सकता है। |
| > 30% | poor | माप त्रुटि निर्णयों पर हावी है। probe संपर्क, socket घिसाव और DIB noise की जाँच करें। |
5. Multi-Site हार्डवेयर Delta विश्लेषण
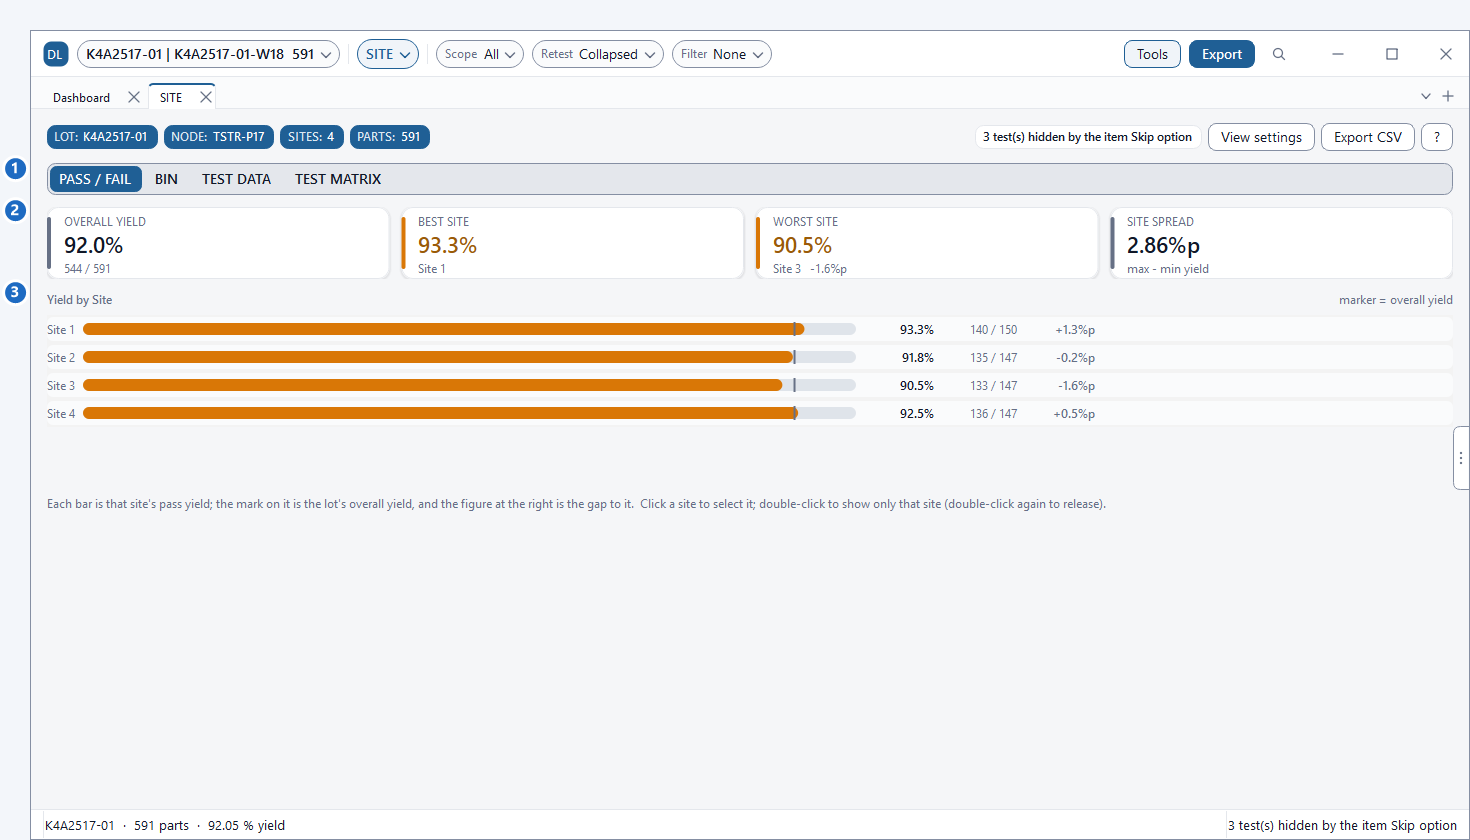
multi-site समानांतर टेस्टिंग में, probe needle scrub, socket संपर्क प्रतिरोध या relay pin घिसाव में असमानताएँ अक्सर किसी एक विशिष्ट site को व्यवस्थित रूप से drift कराती हैं। SITE स्क्रीन हार्डवेयर outliers को तुरंत पहचानने के लिए site के पार yield, BIN संरचना और पैरामीटर औसत की तुलना करती है।
 बड़ा करने के लिए क्लिक करें
| जाँच बिंदु | स्क्रीन | कैसे जाँचें |
|---|---|---|
| कम yield वाला site | SITE > PASS / FAIL | सबसे छोटा बार; WORST SITE कार्ड में हाइलाइट। |
| दोष का केंद्रीकरण | SITE > BIN | देखें कि क्या विशिष्ट Fail BIN किसी एक site पर केंद्रित हैं। |
| पैरामीट्रिक बदलाव | SITE > TEST DATA | कुल माध्य के विरुद्ध site-विशिष्ट PASS die के माध्य विचलन की जाँच करें (Δ vs overall)। |
| Site-प्रधान टेस्ट | SITE > TEST MATRIX | η² (site अंतरों द्वारा समझाए गए कुल variance का अनुपात)। 5% से कम का अर्थ site का न्यूनतम प्रभाव है, जो - के रूप में दिखता है। |
| सांख्यिकीय महत्व | Group Analysis (Group by: Site) | One-way ANOVA p-value और Tukey HSD युग्म-वार तुलना। |
| Site पुनरुत्पादनीयता | Gauge R&R (Cross-Site) | AV का मूल्यांकन करने के लिए समान die मापते समय site को appraiser मानें। |
6. Cpk · Cp · Est ppm · सामान्यता
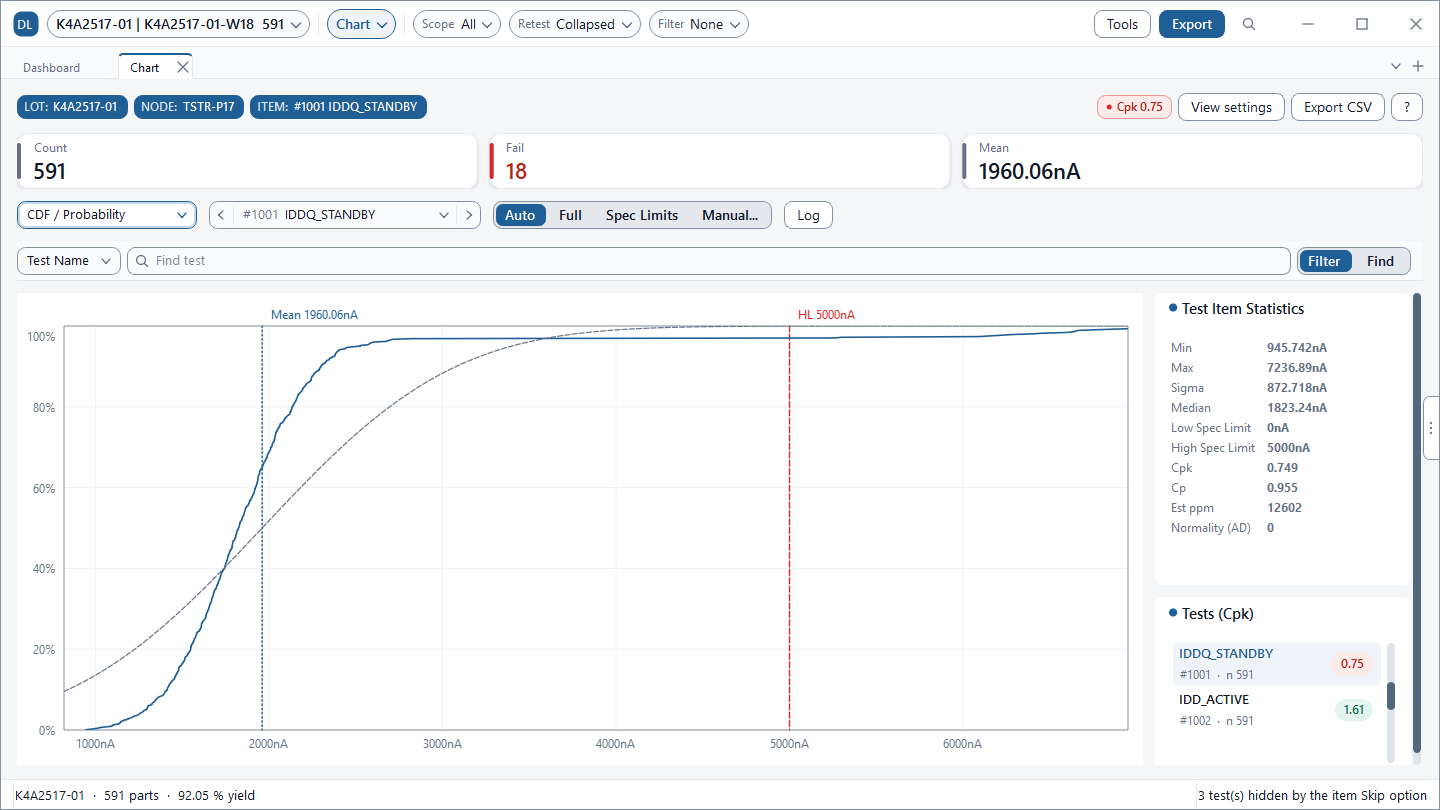
प्रक्रिया-क्षमता सूचकांक मात्रात्मक रूप से बताते हैं कि पैरामीटर वितरण specification limits (LL/HL) के भीतर कितनी अच्छी तरह बैठते हैं। DLOG, Cpk और Cp को Chart स्क्रीन के Test Item Statistics, Tests (Cpk) साइडबार सूची और Dashboard क्षमता सारांश में दिखाता है।
यहाँ $\mu$ और $\sigma$ वर्तमान में चुने हुए दायरे के भीतर नमूना माध्य और नमूना मानक विचलन दर्शाते हैं। Est ppm सामान्य वितरण मानते हुए सैद्धांतिक द्वि-पक्षीय tail प्रायिकता दर्शाता है। एकतरफ़ा limits के लिए केवल लागू tail का मूल्यांकन किया जाता है। Dashboard क्षमता ग्रेडिंग में, Cpk को डिफ़ॉल्ट रूप से Critical (< 1.00), Marginal (1.00 से 1.33) और Good (≥ 1.33) में वर्गीकृत किया जाता है, जिसे सेटिंग में बदला जा सकता है।
| Cpk | Sigma स्तर | सामान्य Tail दोष दर | औद्योगिक संदर्भ |
|---|---|---|---|
1.00 | $3\sigma$ | लगभग 2,700 ppm | माध्य केंद्रित, specification limits तक 3σ margin |
1.33 | $4\sigma$ | लगभग 63 ppm | मानक औद्योगिक निर्माण स्वीकृति बेंचमार्क |
1.50 | $4.5\sigma$ | लगभग 6.8 ppm | नियंत्रित उच्च-yield लाइनों का लक्ष्य |
1.67 | $5\sigma$ | लगभग 0.57 ppm | ऑटोमोटिव और मिशन-क्रिटिकल सेमीकंडक्टर में अपेक्षित |
2.00 | $6\sigma$ | लगभग 0.002 ppm | Six Sigma शून्य-दोष उद्देश्य |
तालिका के मान केंद्रित डेटा और पूर्ण Gaussian सामान्यता मानने वाले सैद्धांतिक आँकड़े हैं। बाध्यकारी स्वीकृति मानदंडों के लिए ग्राहक अनुबंध और औपचारिक उत्पाद विनिर्देशों का पालन करें।
सामान्यता परीक्षण और CDF / Probability प्लॉट
Cpk और Est ppm तभी विश्वसनीय होते हैं जब डेटा वास्तव में Gaussian सामान्य वितरण का अनुसरण करे। DLOG, tail-संवेदी Anderson-Darling परीक्षण का p-value निकालता है, जो Normality (AD) के रूप में दिखाया जाता है। p < 0.05 का मान सामान्यता से महत्वपूर्ण विचलन दर्शाता है।
 बड़ा करने के लिए क्लिक करें
7. सहसंबंध विश्लेषण · ANOVA · TTO
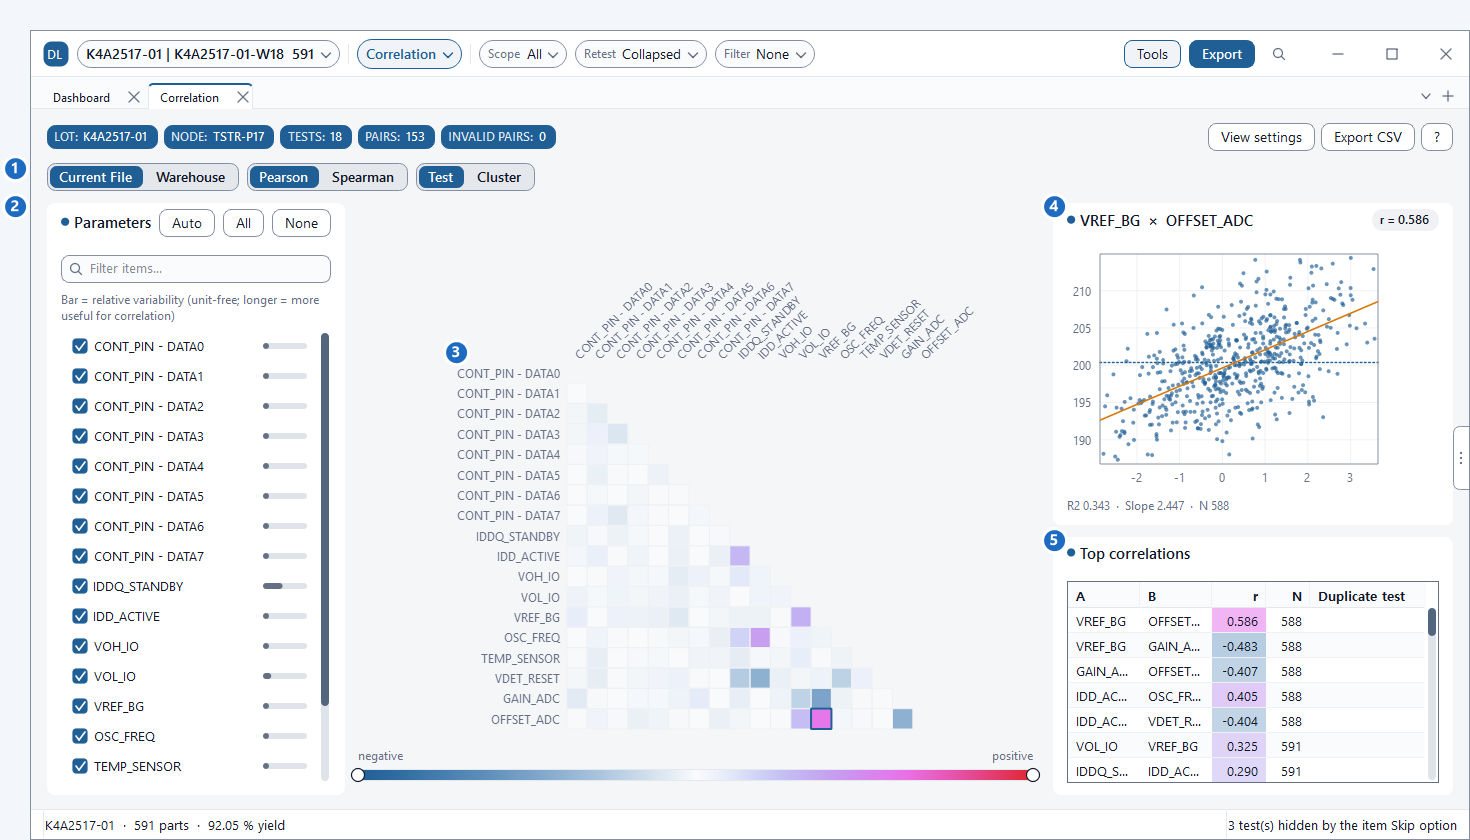
सेमीकंडक्टर टेस्ट में मूल कारण अक्सर किसी एक पैरामीटर में नहीं, बल्कि कई टेस्टों की पारस्परिक क्रियाओं या अलग-अलग संचालन समूहों (site, तापमान, lot, टेस्ट फ़ाइल) में प्रकट होते हैं। Correlation स्क्रीन आँकती है कि पैरामीटर साथ-साथ कैसे बदलते हैं, जबकि Group Analysis सत्यापित करती है कि समूहों के बीच के अंतर सांख्यिकीय रूप से महत्वपूर्ण हैं या नहीं।
 बड़ा करने के लिए क्लिक करें
 बड़ा करने के लिए क्लिक करें
Pearson और Spearman सहसंबंध
Pearson सहसंबंध रैखिक संबंध की शक्ति मापता है, जबकि रैंक-आधारित Spearman सहसंबंध outliers के प्रति मज़बूत है और गैर-रैखिक एकदिष्ट संबंधों को पकड़ता है। Cluster क्रम दृढ़ता से सहसंबद्ध टेस्टों को आपस में सटाकर रखता है ताकि संरचनात्मक ब्लॉक उजागर हों। Parameters को Auto पर सेट करने से मज़बूत सहसंबंध (|r| ≥ 0.70) दिखाने वाले टेस्ट अपने-आप अलग हो जाते हैं।
One-way ANOVA (Analysis of Variance)
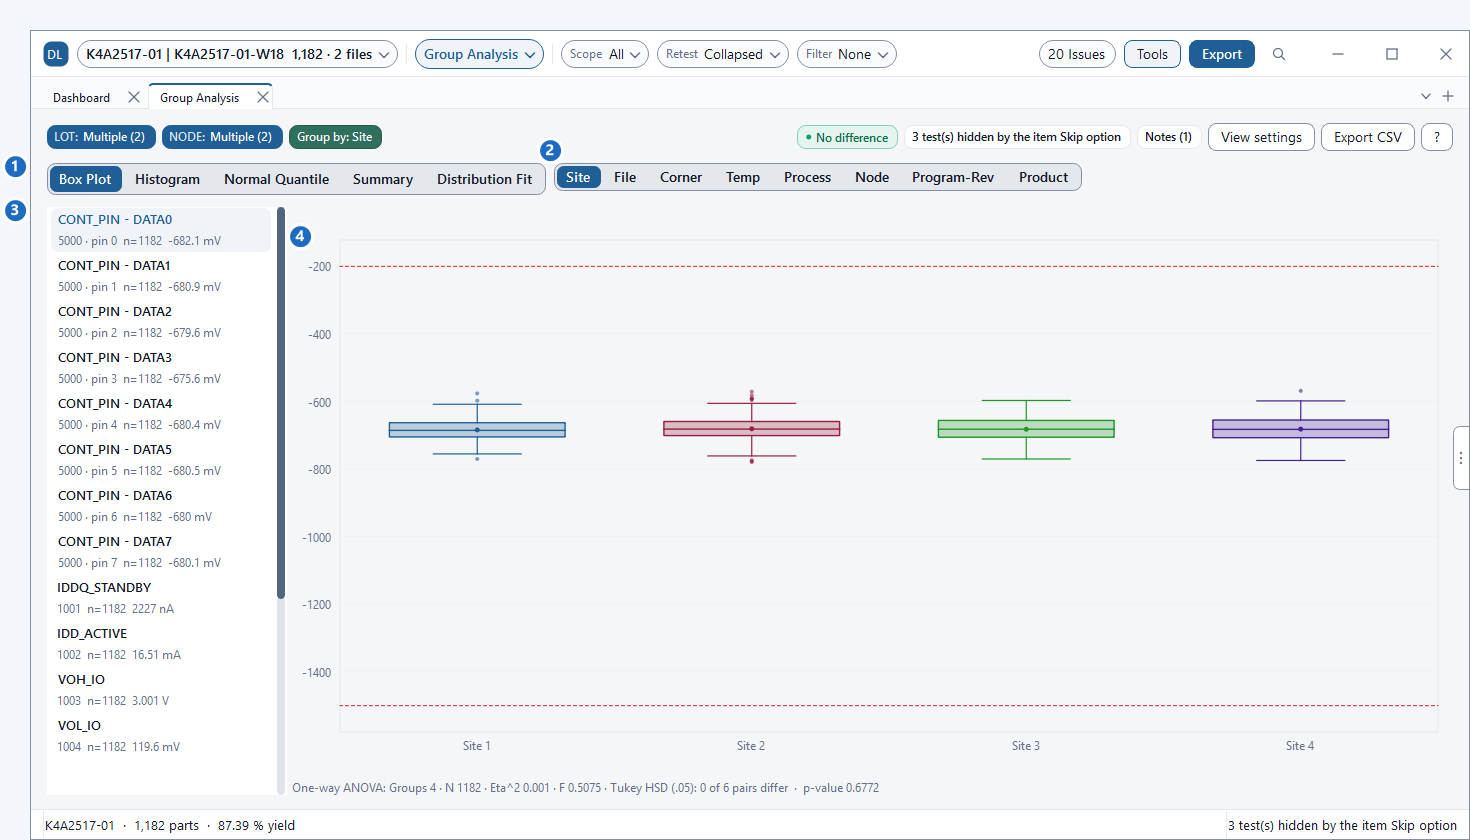
Group Analysis यह निर्धारित करने के लिए कि समूहों के माध्य में महत्वपूर्ण अंतर है या नहीं, टेस्ट परिणामों को Site, File, Corner, Temp, Process, Node, Program-Rev या Product के अनुसार बाँटता है:
- p-value < 0.05: यह मानते हुए कि समूह माध्य समान हैं, वर्तमान अंतर केवल संयोग से देखे जाने की प्रायिकता 5% से कम है। निष्कर्ष निकालें कि कम से कम एक समूह का माध्य महत्वपूर्ण रूप से भिन्न है।
- Eta² (η²): समूह वर्गीकरण द्वारा समझाए गए कुल variance का अनुपात। 0 के करीब का अर्थ है नगण्य समूह प्रभाव; 0.40 का अर्थ है पैरामीटर विविधता का 40% समूह अंतरों से आता है।
- Tukey HSD: भिन्न युग्मों की सटीक संख्या बताने के लिए युग्म-वार समूह अंतर का मूल्यांकन करता है (जैसे “0 of 6 pairs differ”)।
चित्र 7-2 का उदाहरण Eta² 0.001 और p-value 0.6772 दिखाता है, जो पुष्टि करता है कि site में कोई महत्वपूर्ण विविधता नहीं है। हरा status pill No difference तुरंत पुष्टि देता है।
8. प्रक्रिया Drift बनाम माप Noise
जब Cpk गिरता है या yield घटता है, तो fab टीमें टेस्ट हार्डवेयर पर शक करती हैं, जबकि टेस्ट टीमें front-end wafer निर्माण पर। DLOG की विश्लेषण स्क्रीनों को मिलाकर, आप अनुभवजन्य डेटा के साथ मूल कारणों में अंतर कर सकते हैं।
| जाँच क्षेत्र | Fab / प्रक्रिया मूल कारण | टेस्टर / माप मूल कारण |
|---|---|---|
| स्थानिक पैटर्न (Wafer > Signature) |
संकेंद्री रिंग, wafer किनारे पर गिरावट, केंद्र में hot spot, स्थानीय क्लस्टर | शून्य के करीब cluster score (यादृच्छिक) के साथ कम yield, shot-pitch या site आवर्तता |
| Site Delta (SITE, Group Analysis) |
सभी टेस्ट site में एकसमान वितरण | एकल site offset, महत्वपूर्ण One-way ANOVA p-value |
| माप प्रणाली (Gauge R&R) |
कम %GRR, Part Variation (PV) हावी | उच्च %GRR, Equipment (EV) या Appraiser (AV) विविधता हावी |
| समय-श्रृंखला Trend (Chart > Trend) |
wafer या lot सीमाओं के अनुरूप चरणबद्ध बदलाव | टेस्ट क्रम के पार निरंतर drift, probe card/socket सर्विस के बाद अचानक बदलाव |
| सुधारात्मक कार्रवाई | Fab उपकरण और recipe (litho, etch, CMP, deposition) की जाँच करें | probe card / socket साफ़ करें या बदलें, docking सत्यापित करें, DIB grounding की जाँच करें |
9. अक्सर पूछे जाने वाले प्रश्न और रिपोर्ट
अक्सर पूछे जाने वाले प्रश्न (FAQ)
Cpk मानक Gaussian वितरण मानकर एक ही पैरामीटर का मूल्यांकन करता है। गैर-सामान्य वितरण (bimodal वितरण, भारी tail) या ऐसे बहु-टेस्ट संयोजन जो अदिश limits पास करते हैं लेकिन भौतिक सहसंबंध तोड़ते हैं, उन्हें अकेला Cpk नहीं पकड़ सकता। सूक्ष्म outlier escape पकड़ने के लिए PAT+ (DPAT · SPAT) और MVA (MVA Explorer, Wafer MVA-PAT) को मिलाएँ।
Gauge R&R Detail के अंतर्गत variance घटकों की जाँच करें। यदि EV हावी है, तो टेस्टर noise, grounding, power supply ripple और shielding पर ध्यान दें। यदि AV हावी है, तो फ़ाइल या site अंतरों (socket घिसाव, docking संरेखण, calibration) की जाँच करें।
आपको ठीक उसी wafer के दोहराए गए टेस्ट रन की कम से कम 2 STDF फ़ाइलें चाहिए, जिनमें die (X, Y) निर्देशांक हों। retest फ़ाइलें Append... से लोड करें। निर्देशांक रिकॉर्ड रहित पैकेज्ड final test डेटा संरेखित नहीं किया जा सकता।
हाँ। तालिका डेटा सहेजने के लिए किसी भी स्क्रीन में Export CSV पर क्लिक करें। औपचारिक PDF, Excel (.xlsx), Word (.docx) या इमेज रिपोर्ट बनाने के लिए Export > Save Report का उपयोग करें। प्रति-टेस्ट 1 पृष्ठ वाले PAT limit चार्ट PAT (PDF) से export करें।
DLOG के साथ प्रक्रिया-क्षमता और माप विश्वसनीयता का अनुभव करें
PAT+ outlier स्क्रीनिंग, MVA explorer, Gauge R&R, multi-site variance और Cpk क्षमता आँकड़े।
6 महीने के निःशुल्क परीक्षण के साथ 100% ऑफ़लाइन वातावरण में अपने STDF datalog का विश्लेषण करें।